Was ich für Sie als KI-Agenten Entwickler baue
Ich entwickle Agenten in Ihrem bestehenden Stack (Node, Python, Java, .NET) mit den Frameworks, die zu Ihrem Use Case passen: Anthropic Tool Use, OpenAI Agents SDK, LangGraph, Microsoft Semantic Kernel. Das Framework ist die kleinste Entscheidung. Wichtiger ist, was drumherum passiert.
Jeder Agent läuft am Ende durch Code-Review, hat Tests für die Tool-Layer, ein Eval-Set für die LLM-Antworten und ein Dashboard für Token-Verbrauch und Tool-Erfolgsraten.
- Customer-Support-Agenten: Tickets klassifizieren, Stammdaten anreichern, Antwortentwürfe vorbereiten
- Procurement-Agenten: Lieferantenanfragen, Angebotsvergleich, Bestellung mit Bestätigung
- Research-Agenten: strukturierte Recherche, Quellenliste, Markdown-Briefing
- Datenextraktion-Agenten: komplexe PDFs lesen, strukturierte Felder, Zielsystem-Write
- Code- und DevOps-Agenten: Bugfixes, Releases, Routine-PRs in Ihrem Repo
Was ich nicht baue und warum
Ehrliche Vorab-Filter sparen beiden Seiten Zeit. Drei Dinge baue ich bewusst nicht.
Erstens: vollautonome Agenten, die ohne Eskalation Geld bewegen oder Verträge schließen. Das Risiko-Ertrags-Verhältnis stimmt heute noch nicht.
Zweitens: Agenten ohne klare Erfolgsmetrik. Wenn niemand sagen kann, wie wir messen, ob der Agent gut funktioniert, baue ich erst die Metrik.
Drittens: Agenten als Selbstzweck, wo ein deterministischer Workflow oder eine RAG-Antwort reicht. Ein Agent ist die teuerste Architektur: Er sollte nur dort sein, wo er gebraucht wird.
Wie ein typisches Agenten-Projekt mit mir abläuft
Ich arbeite in drei Stufen, die jede für sich einen Wert liefern. Sie können nach jeder Stufe entscheiden, ob es weitergeht.
- Discovery (5 Tage, Festpreis): Use Case schärfen, Tools definieren, Erfolgsmetrik festlegen, Architektur-Skizze, Risiko-Klassifizierung (auch im EU-AI-Act-Kontext)
- Pilot (3–6 Wochen): Read-only Agent in Ihrer Umgebung, mit echten Daten, mit Eval-Set. Am Ende: Demo gegen die definierten Metriken.
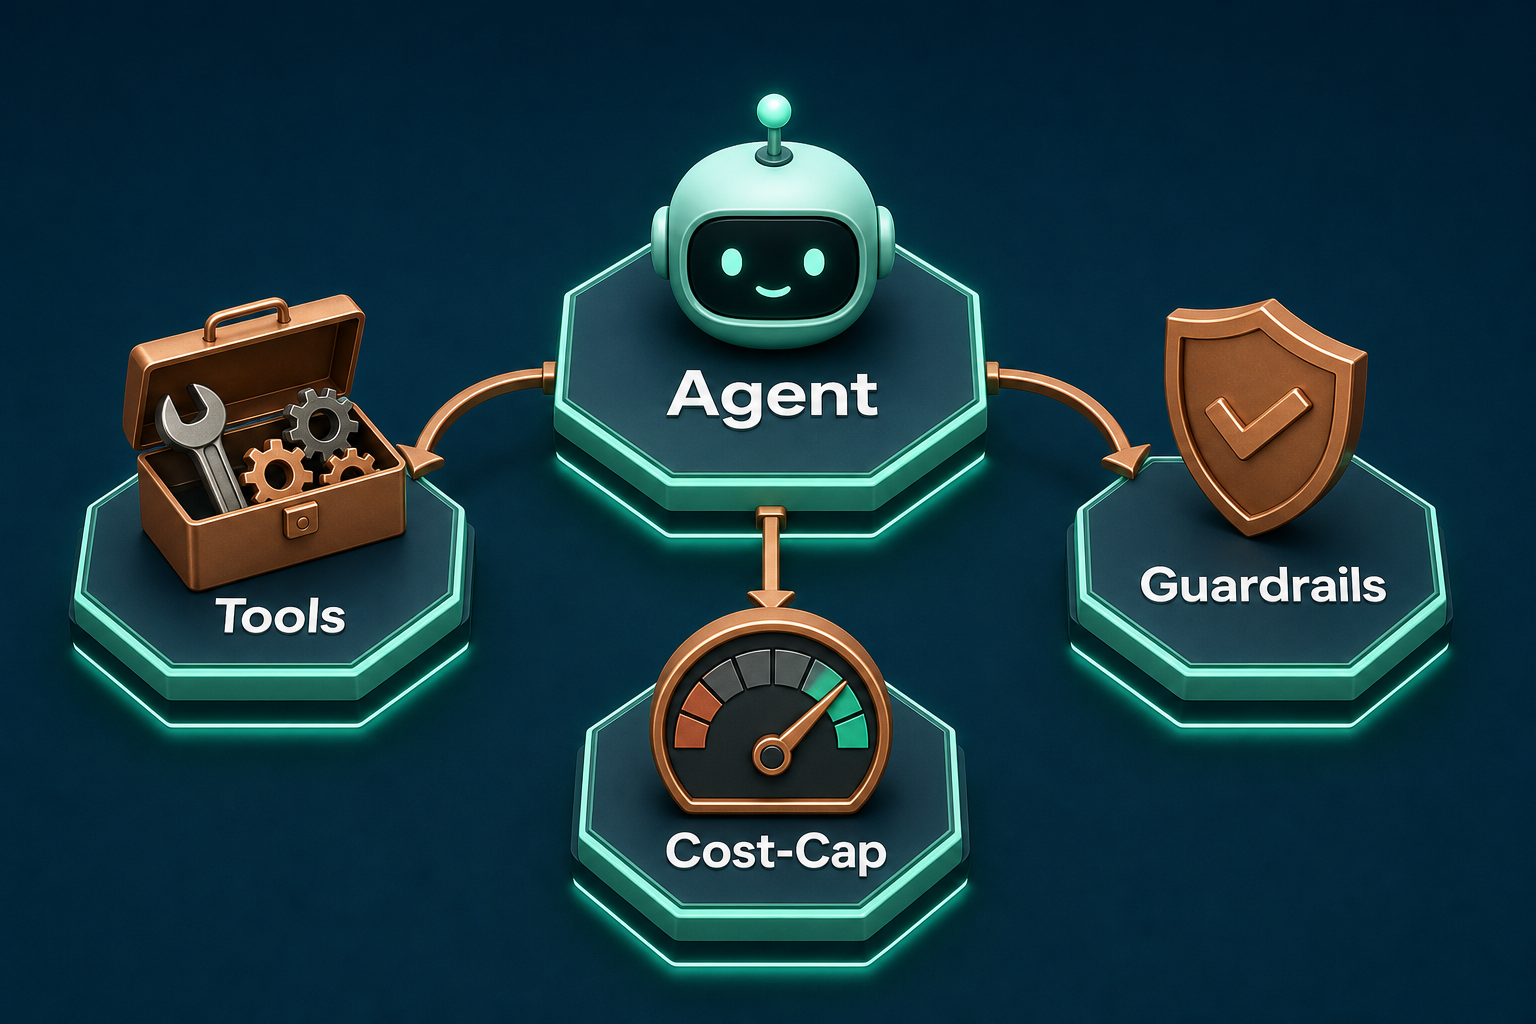
- Produktivierung (4–10 Wochen): Write-Aktionen mit Human-in-the-Loop, Guardrails, Tracing, Cost-Caps, Übergabe-Doku, optional Schulung Ihres Teams
Stack und Frameworks, mit denen ich arbeite
Ich bin Framework-agnostisch und wähle pro Projekt. Was ich nicht mache: ein Tool aus Liebhaberei einsetzen, das nicht zu Ihrem Stack passt.
- Modelle: Claude Sonnet/Opus, GPT-4/4.1, Gemini, lokale Modelle (Llama, Mistral) wo DSGVO-Anforderungen es verlangen
- Frameworks: LangGraph, OpenAI Agents SDK, Anthropic Tool Use direkt, Semantic Kernel, AutoGen, pro Use Case
- Orchestrierung: n8n, Temporal, Inngest oder eigenes Backend, je nach bestehender Infrastruktur
- Vector Stores: Qdrant, pgvector, Azure AI Search, Pinecone, pro Anforderung
- Observability: LangSmith, Helicone, OpenLLMetry oder eigenes Logging, eingebettet in Ihre vorhandene Pipeline